

Microsoft desvela VALL-E, una AI que imita voces con ejemplos de tan solo 3 segundos
Un equipo de investigadores de Microsoft ha publicado un artículo académico en el que describen una AI que es capaz de imitar voces a partir de ejemplos de tan solo 3 segundos de duración.
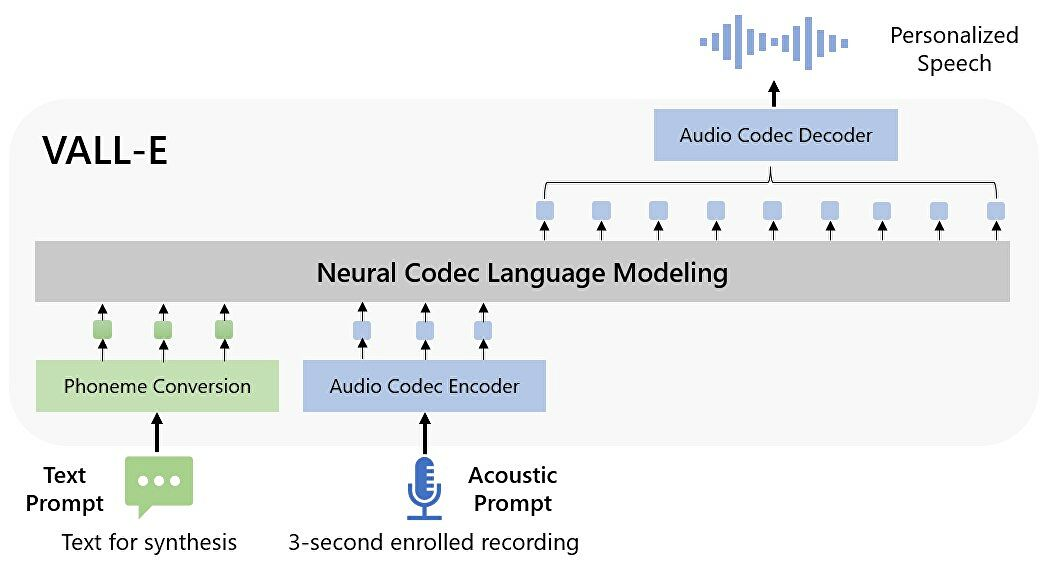
Han publicado varios ejemplos demonstrativos en valle.github.io pero de momento no hay manera de jugar con la AI.
El abstract del artículo contiene más detalles:
We introduce a language modeling approach for text to speech synthesis (TTS). Specifically, we train a neural codec language model (called VALL-E) using discrete codes derived from an off-the-shelf neural audio codec model, and regard TTS as a conditional language modeling task rather than continuous signal regression as in previous work. During the pre-training stage, we scale up the TTS training data to 60K hours of English speech which is hundreds of times larger than existing systems. VALL-E emerges in-context learning capabilities and can be used to synthesize high-quality personalized speech with only a 3-second enrolled recording of an unseen speaker as an acoustic prompt. Experiment results show that VALL-E significantly outperforms the state-of-the-art zero-shot TTS system in terms of speech naturalness and speaker similarity. In addition, we find VALL-E could preserve the speaker’s emotion and acoustic environment of the acoustic prompt in synthesis.

17 Ene 2023, 11:00
-
Nintendo está intentando patentar ideas muy básicas

-
Bram Moolenaar, creador del editor de texto Vim, ha fallecido
-
Amazon Prime Video Monitoring abandona microservicios y reduce costes un 90%
-
Hugging Face lanza una alternativa a ChatGPT: Hugging Chat
-
Las IAs generativas están diezmando puestos de trabajo del sector de los videojuegos en China
-
NVIDIA anuncia Picasso, una suite de herramientas IA generativas
-
Twitter publica su algoritmo de recomendación de tweets
-
Google introduce MusicLM, una IA para generar música
-
Google anuncia Bard, un nuevo chatbot similar a ChatGPT
-
Acceder a la API de Twitter dejará de ser gratis a partir del 9 de febrero
Tengo un video por aquí con más de 3 segundos de “PiPePiTo” y “pero PiPePiTo”. Me pregunto si podría conectar esta AI a un chat de voz de Discord y que produjese sonido en tiempo real.
(Imaginando…)
🤤
Es el tipico avance que hace que cualquier policia haga facepalm porque sabe la que le viene encima… como por ejemplo cuando salieron las impresoras 3d, lo primero que piensa un policia es… joder… ahora se van a poder imprimir las armas en su casa los malos… que luego tiene infinidad de usos beneficiosos para la sociedad y tal, pero esto es mas de lo mismo… muy gracioso hasta que los scammers empiecen a dominarlo y utilizarlo para hacer el mal a las personas mas vulnerables…
Entre esto, las otras IAs y así miedo me da con el cuidado que se va a tener para hacer/decir cualquier cosa o interactuar en Internet…
Yo creo que mucha gente va a seguir prefiriendo compartir a pesar de los riesgos porque el coste de oportunidad de no hacerlo por su forma de vida, valores y objetivos es demasiado alto. Llevamos décadas con Photoshop y cuando veo indicios de abuso es generalmente en temas de publicidad (“photoshop fails”). Ve a donde haya dinero (ingeniería social, poca seguridad, etc).
Sería todo un reto digno del mejor en el Valhalla, campeón entre webmasters, pero no sé yo si un unrealer….
yo usaba este: https://uberduck.ai/
que tiene una gran variedad de voces famosas sintetizadas, lo malo es que hay muchas frases que no las lee bien y tienes que volver a escribir la frase dejando espacios o saltos de linea o hasta buscar sinonimos porque hay palabras que las lee muy mal. Especialmente cuando hay palabras que acaban foneticamente similar a como suena la palabra que la sigue, se monta un lio y no se entiende.
Subiria aqui un fake que hice hace unos dias con la voz de Morty pero creo que es demasiado hardcore para GM… oh geez!